1. Data
Enunciado
Como reproduzir
Todo o código está em code/. Um único script roda os três exercícios em ordem, com um único gerador rng = np.random.default_rng(42), grava as figuras em figures/ e os números em code/results.json. Todos os números deste relatório vêm desse arquivo. O Exercise 3 lê code/data/train.csv, o arquivo rotulado da competição Spaceship Titanic do Kaggle. Ele está no repositório para que o código rode num checkout limpo.
python3 -m venv env && source ./env/bin/activate
python3 -m pip install -r requirements.txt
python docs/exercises/data/code/run_all.py
Código — code/run_all.py e code/common.py
Exercise 1
Abordagem. Cada classe é uma gaussiana 2D com covariância diagonal: amostro \(x\) e \(y\) de forma independente, com a média e o desvio do enunciado. Para estudar o espalhamento, multiplico todos os desvios por \(s\) e mantenho as médias. Meço a separação de duas formas, sem treinar nada: o separation ratio \(r_{ij}\), calculado com os parâmetros, e o mixing rate, calculado com os pontos sorteados.
Código — code/ex1_point_clouds.py
| docs/exercises/data/code/ex1_point_clouds.py | |
|---|---|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 173 174 175 176 177 178 179 180 181 182 183 | |
A — Generate the clouds
A função generate(rng, s=1.0) sorteia 100 pontos por classe com rng.normal(média, desvio × s). São 400 pontos, 4 classes e 100 amostras por classe.
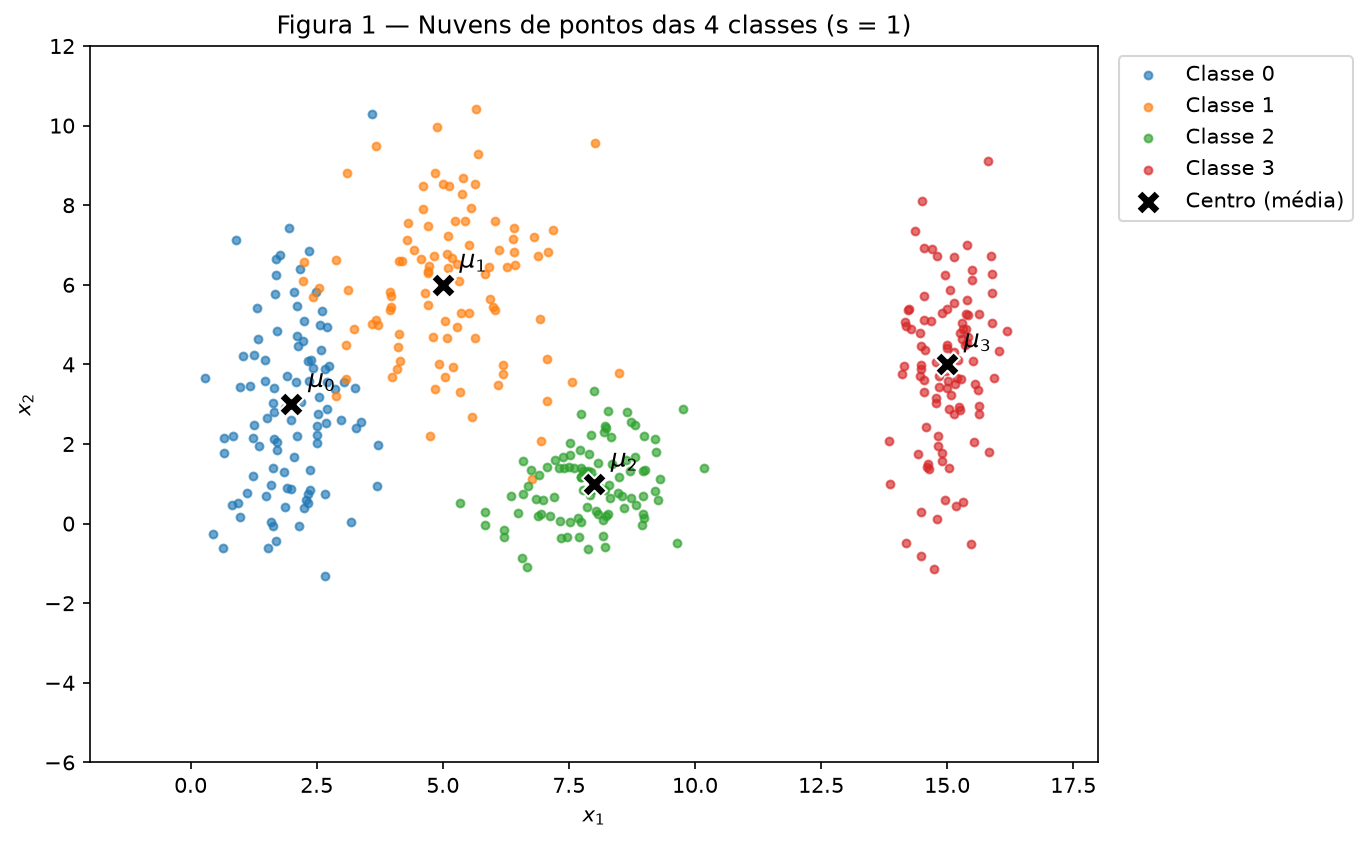
Figura 1 — As 4 nuvens de pontos com \(s = 1\). O X preto marca o centro (média) de cada classe.
B — More or less spread out
Gero as mesmas 4 classes com \(s \in \{0.5,\ 1.0,\ 2.0,\ 4.0\}\). São 4 datasets, cada um com as 4 classes. O dataset de \(s = 1\) é o próprio dataset do item A. Assim, a Figura 1 e o painel \(s = 1\) da Figura 2 mostram os mesmos pontos.
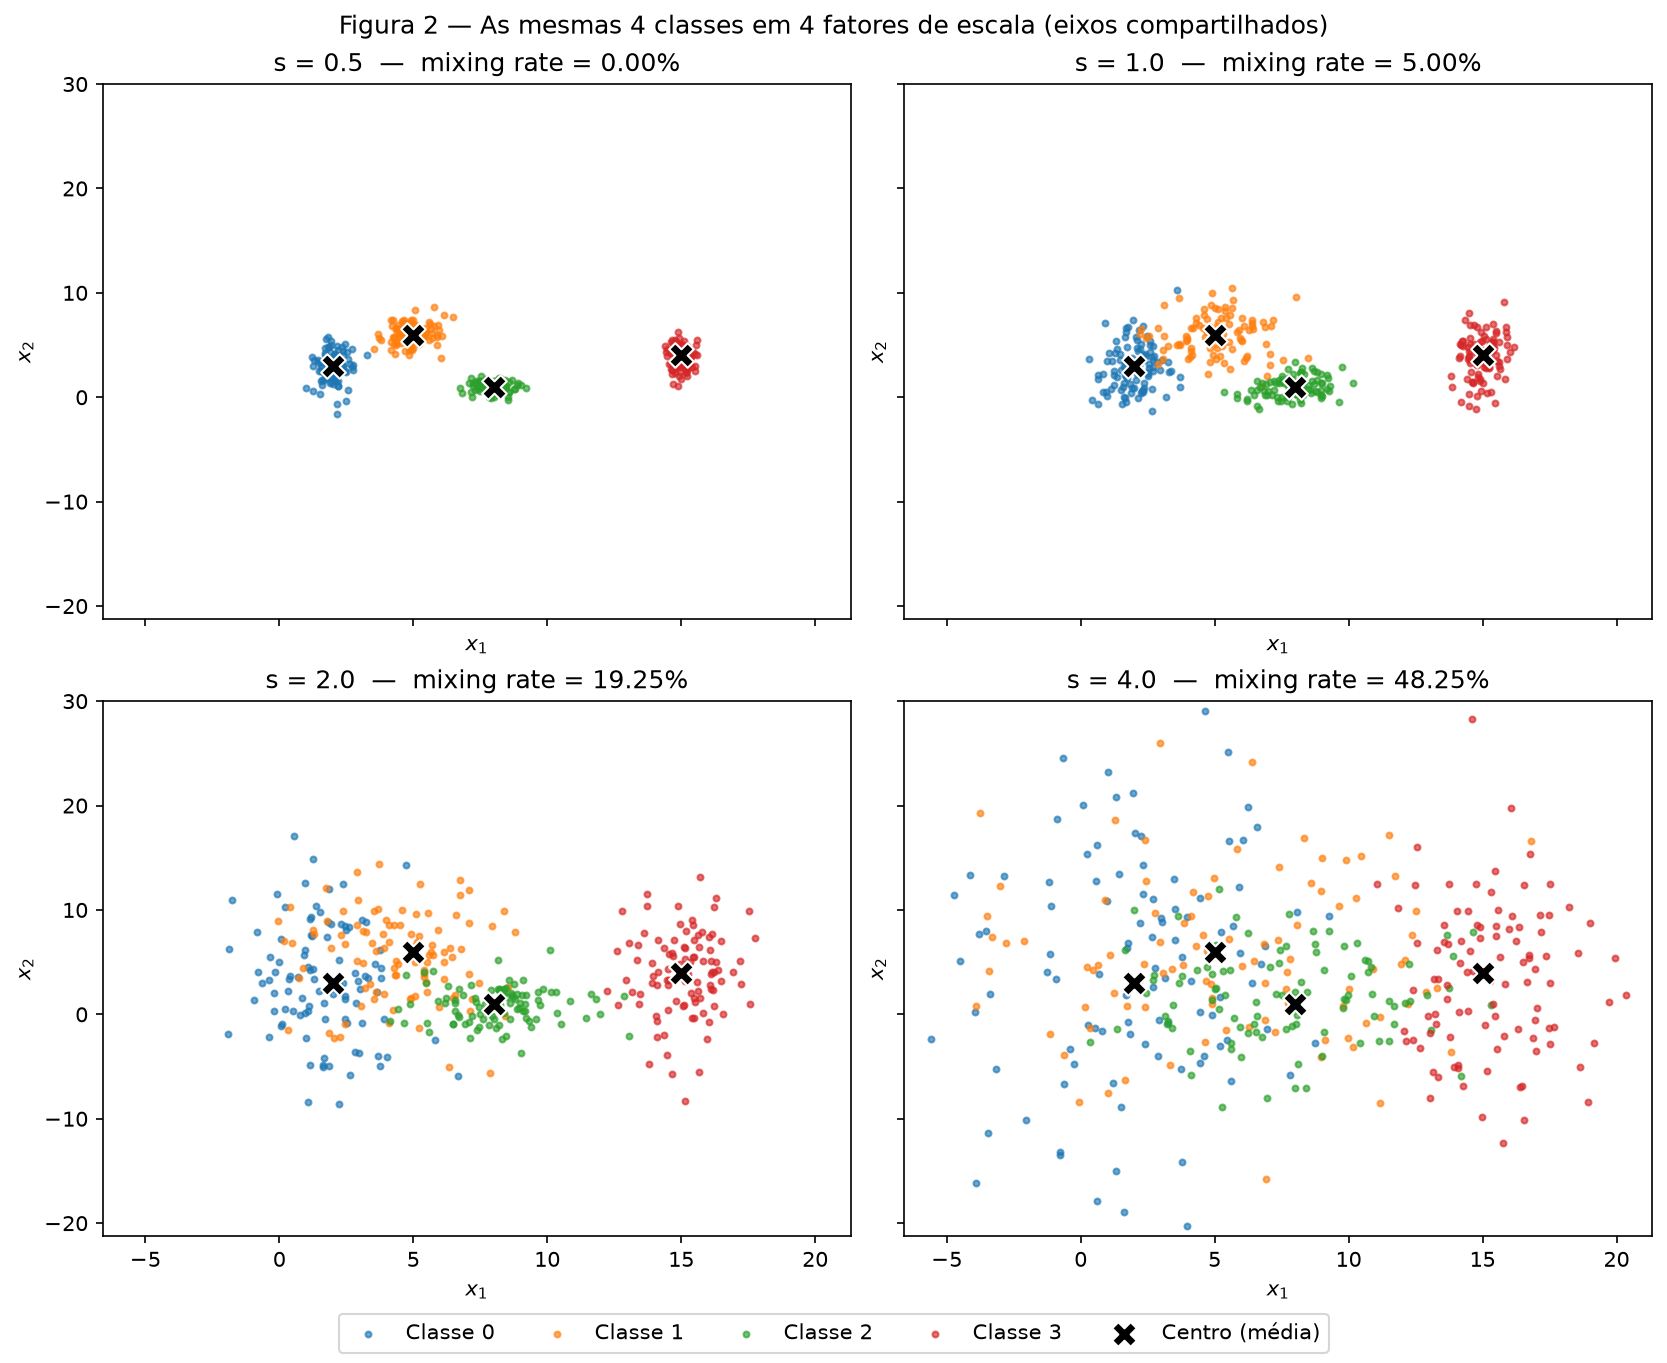
Figura 2 — As mesmas 4 classes nos 4 fatores de escala. Os 4 painéis têm os mesmos limites de eixo.
Separation ratio em \(s = 1\). Com \(\bar\sigma_0 = 1.65\), \(\bar\sigma_1 = 1.55\), \(\bar\sigma_2 = 0.90\) e \(\bar\sigma_3 = 1.25\):
| Par \((i, j)\) | \(\lVert \mu_i - \mu_j \rVert\) | \(\bar\sigma_i + \bar\sigma_j\) | \(r_{ij}\) |
|---|---|---|---|
| (0, 1) | 4.243 | 3.20 | 1.326 |
| (0, 2) | 6.325 | 2.55 | 2.480 |
| (0, 3) | 13.038 | 2.90 | 4.496 |
| (1, 2) | 5.831 | 2.45 | 2.380 |
| (1, 3) | 10.198 | 2.80 | 3.642 |
| (2, 3) | 7.616 | 2.15 | 3.542 |
O menor valor é \(r_{01} = 1.33\), do par de classes 0 e 1. As médias não mudam e os desvios são multiplicados por \(s\), então \(r_{ij}\) é dividido por \(s\). Em \(s = 2\), o menor valor passa a ser \(r_{01} = 1.33 / 2 = 0.66\). O script confere esse valor recalculando a fórmula com os desvios dobrados.
Mixing rate. Para cada ponto, calculo a distância até os 4 centros do enunciado. Um ponto "mistura" quando o centro mais próximo não é o da sua classe.
| \(s\) | Mixing rate | Pontos misturados | Menor \(r_{ij}\) |
|---|---|---|---|
| 0.5 | 0.0% | 0 / 400 | 2.65 |
| 1.0 | 5.0% | 20 / 400 | 1.33 |
| 2.0 | 19.25% | 77 / 400 | 0.66 |
| 4.0 | 48.25% | 193 / 400 | 0.33 |
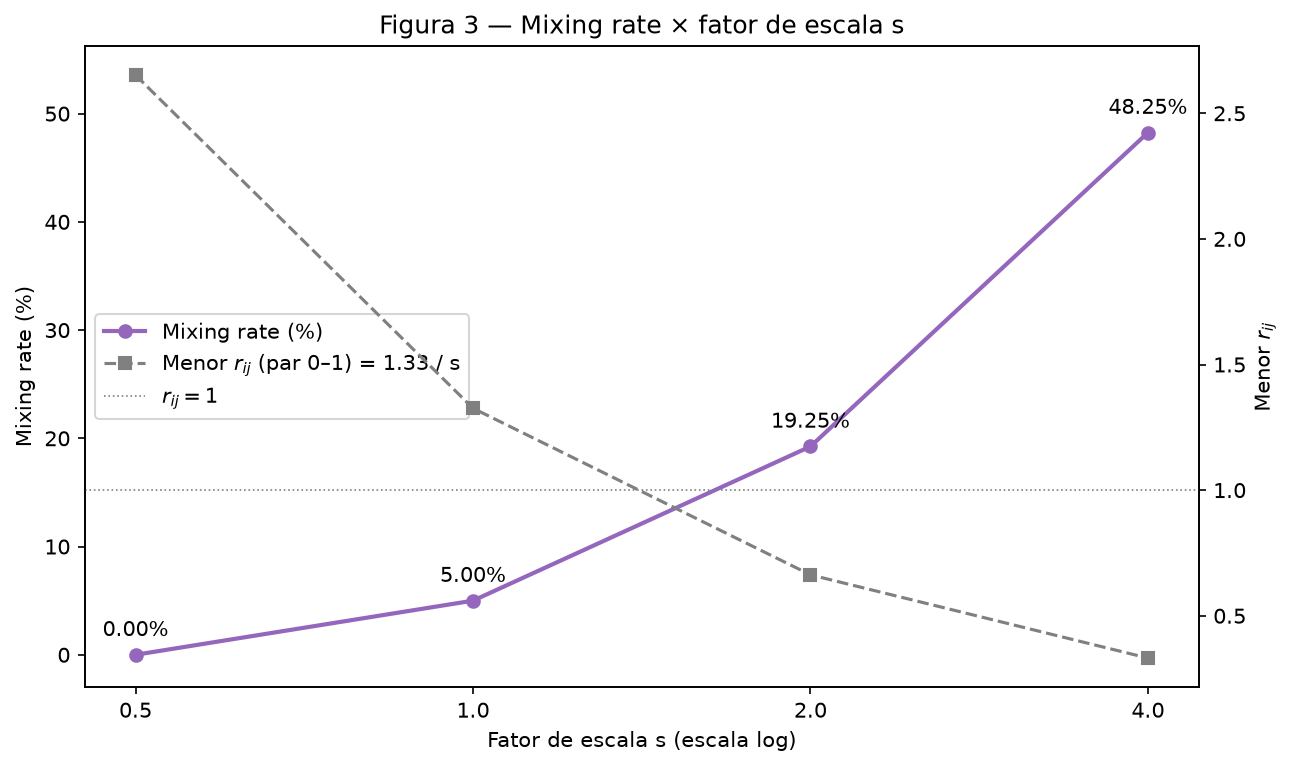
Figura 3 — Mixing rate em função de \(s\) (esquerda) e menor \(r_{ij}\), que cai como \(1/s\) (direita).
A partir de qual \(s\) as nuvens deixam de ser separáveis por retas? A partir de \(s = 1.0\). A regra "centro mais próximo" já é um conjunto de retas: a fronteira entre dois centros é a mediatriz do segmento que os une. Em \(s = 0.5\), essas retas separam os 400 pontos sem erro. Em \(s = 1.0\), 20 pontos ficam do lado errado: 8 pontos da classe 0 estão mais perto de \(\mu_1\), 6 da classe 1 estão mais perto de \(\mu_0\) e outros 6 estão mais perto de \(\mu_2\). Nesse ponto, o menor \(r_{ij}\) vale 1.33: a distância entre \(\mu_0\) e \(\mu_1\) é só 1.33 vez a soma dos desvios médios, e as caudas das duas nuvens já se cruzam. Quando \(s\) passa de \(1.33\), \(r_{01}\) fica abaixo de 1. Em \(s = 2\) (\(r_{01} = 0.66\)), a mistura sobe para 19.25%.
C — Analysis
Sobreposição em \(s = 1\). A mistura fica quase toda no par 0–1, o de menor \(r_{ij}\) (1.33). Das 20 trocas, 14 são entre essas duas classes. A classe 0 é alta (\(\sigma_y = 2.5\)) e invade a região da classe 1. A classe 2 é compacta (\(\sigma = 0.9\)): nenhum ponto dela mistura, mas 6 pontos da classe 1 caem mais perto de \(\mu_2\). A classe 3 fica isolada à direita (\(r_{03} = 4.50\), \(r_{13} = 3.64\), \(r_{23} = 3.54\)), sem nenhum ponto misturado.
Uma única fronteira linear separa as 4 classes? Não. Uma reta divide o plano em só duas regiões, e há 4 classes. Uma reta separa bem só uma classe do resto: a classe 3, com uma reta vertical perto de \(x_1 \approx 12\).
E um conjunto de fronteiras lineares? Separa quase tudo. As retas do "centro mais próximo" já acertam 95% dos pontos. Os 5% restantes são pontos que entraram na nuvem vizinha. Para acertá-los, as fronteiras teriam de contornar ponto a ponto. Isso decora o ruído desta amostra e não vale para novos pontos.
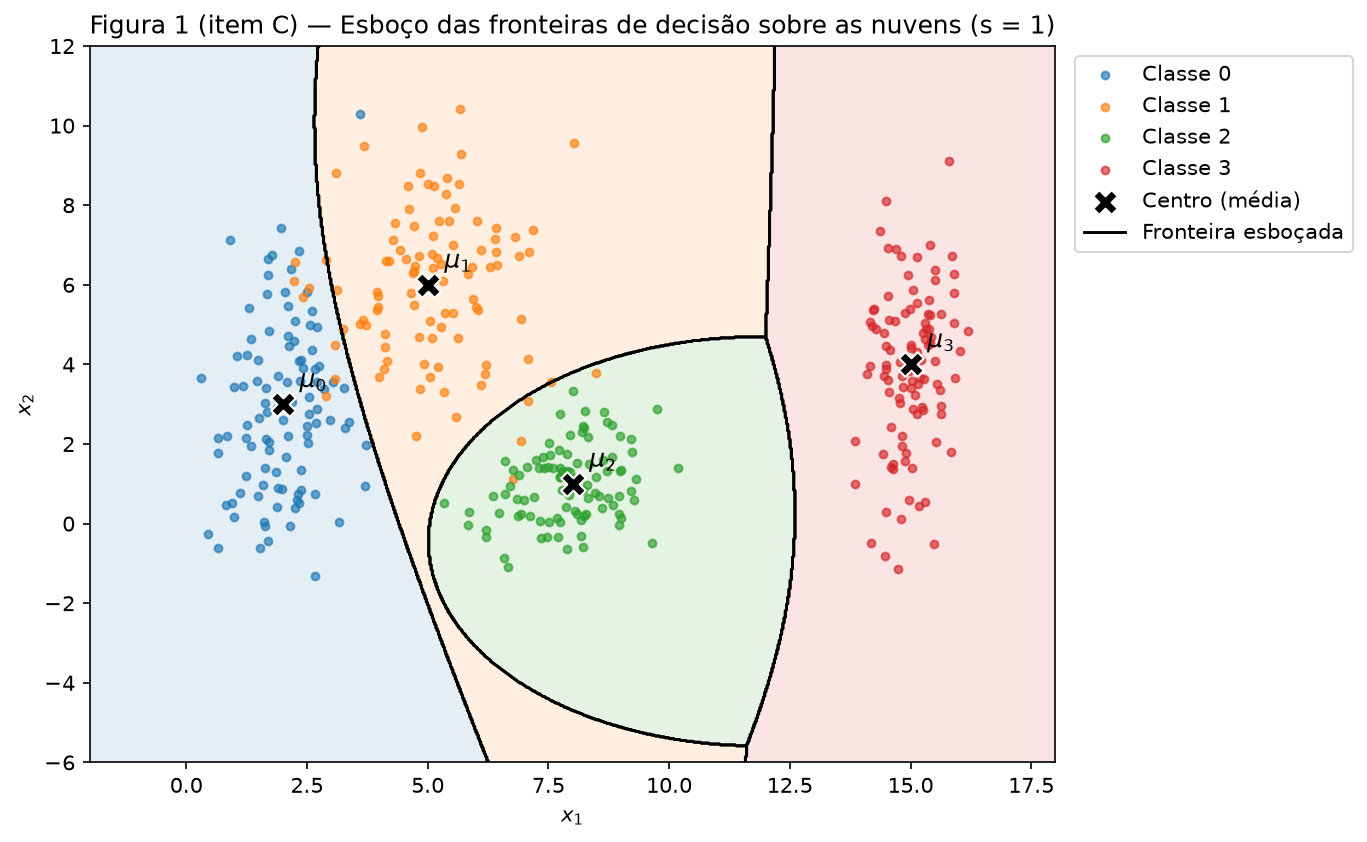
Figura 1 (item C) — Esboço das fronteiras que uma rede treinada tenderia a aprender, sobre a Figura 1.
Como o esboço foi feito. Para cada ponto do plano, pintei a classe de maior densidade, usando as gaussianas do enunciado. Nenhum modelo foi treinado: é a fronteira ideal para esses parâmetros, e uma rede bem treinada tende a se aproximar dela. O esboço mostra três coisas:
- a fronteira 3 × resto é quase uma reta vertical em \(x_1 \approx 12\);
- a fronteira 0 × 1 é uma curva suave na diagonal, entre as duas nuvens;
- a classe 2 fica dentro de uma região fechada e curva. Ela é mais compacta que as vizinhas, e por isso a densidade dela só vence perto do centro.
Uma rede com camadas ocultas (tanh, por exemplo) desenha curvas assim. Um perceptron sozinho desenha só uma reta.
Relação com o item B. Mais espalhamento aumenta a região em que as classes se sobrepõem. Nessa região, um mesmo lugar do plano tem pontos de duas classes, e nenhuma fronteira acerta os dois. A rede pode só escolher o melhor lado, e o erro dessa região não cai com mais treinamento. Os números mostram esse crescimento: o mixing rate vai de 0% para 5%, 19.25% e 48.25%, e o menor \(r_{ij}\) cai de 2.65 para 1.33, 0.66 e 0.33. Em \(s = 4\), quase metade dos pontos está mais perto do centro errado.
Exercise 2
Abordagem. Gero dois datasets em 5D, cada um com 500 pontos por classe. O Dataset I tem duas gaussianas com centros diferentes. O Dataset II tem um núcleo dentro de uma casca, com o mesmo centro. Comparo os dois de três formas: projeção PCA em 2D, distância entre os centros das classes e raio \(\lVert x \rVert\) de cada ponto. As duas últimas medidas usam os dados 5D originais.
Código — code/ex2_nonlinearity.py
| docs/exercises/data/code/ex2_nonlinearity.py | |
|---|---|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 | |
A — Dataset I: shifted Gaussians
Antes de amostrar, confiro se as duas matrizes do enunciado são covariâncias válidas (simétricas e positivas definidas). O menor autovalor é 0.158 para \(\Sigma_A\) e 0.498 para \(\Sigma_B\). Os dois são positivos, então as matrizes são válidas. Amostro com rng.multivariate_normal(mu, Sigma, size=500, method="cholesky"). A decomposição de Cholesky é única, então o resultado não depende da biblioteca de álgebra linear da máquina.
B — Dataset II: concentric shells
Cada ponto é \(x = \rho \cdot u\):
- Direção \(u\): sorteio \(v \sim \mathcal{N}(0, I_5)\) e normalizo, \(u = v / \lVert v \rVert\). A gaussiana \(\mathcal{N}(0, I_5)\) tem a mesma forma em todas as direções. Por isso a direção normalizada é uniforme na esfera unitária.
- Raio \(\rho\): \(\mathcal{N}(2.0,\ 0.4)\) na classe C (núcleo) e \(\mathcal{N}(5.0,\ 0.4)\) na classe D (casca). Leio 0.4 como desvio padrão, a convenção de
rng.normal. Um raio negativo exigiria um desvio de 5σ abaixo da média, o que não acontece na prática.
C — Visualize and compare
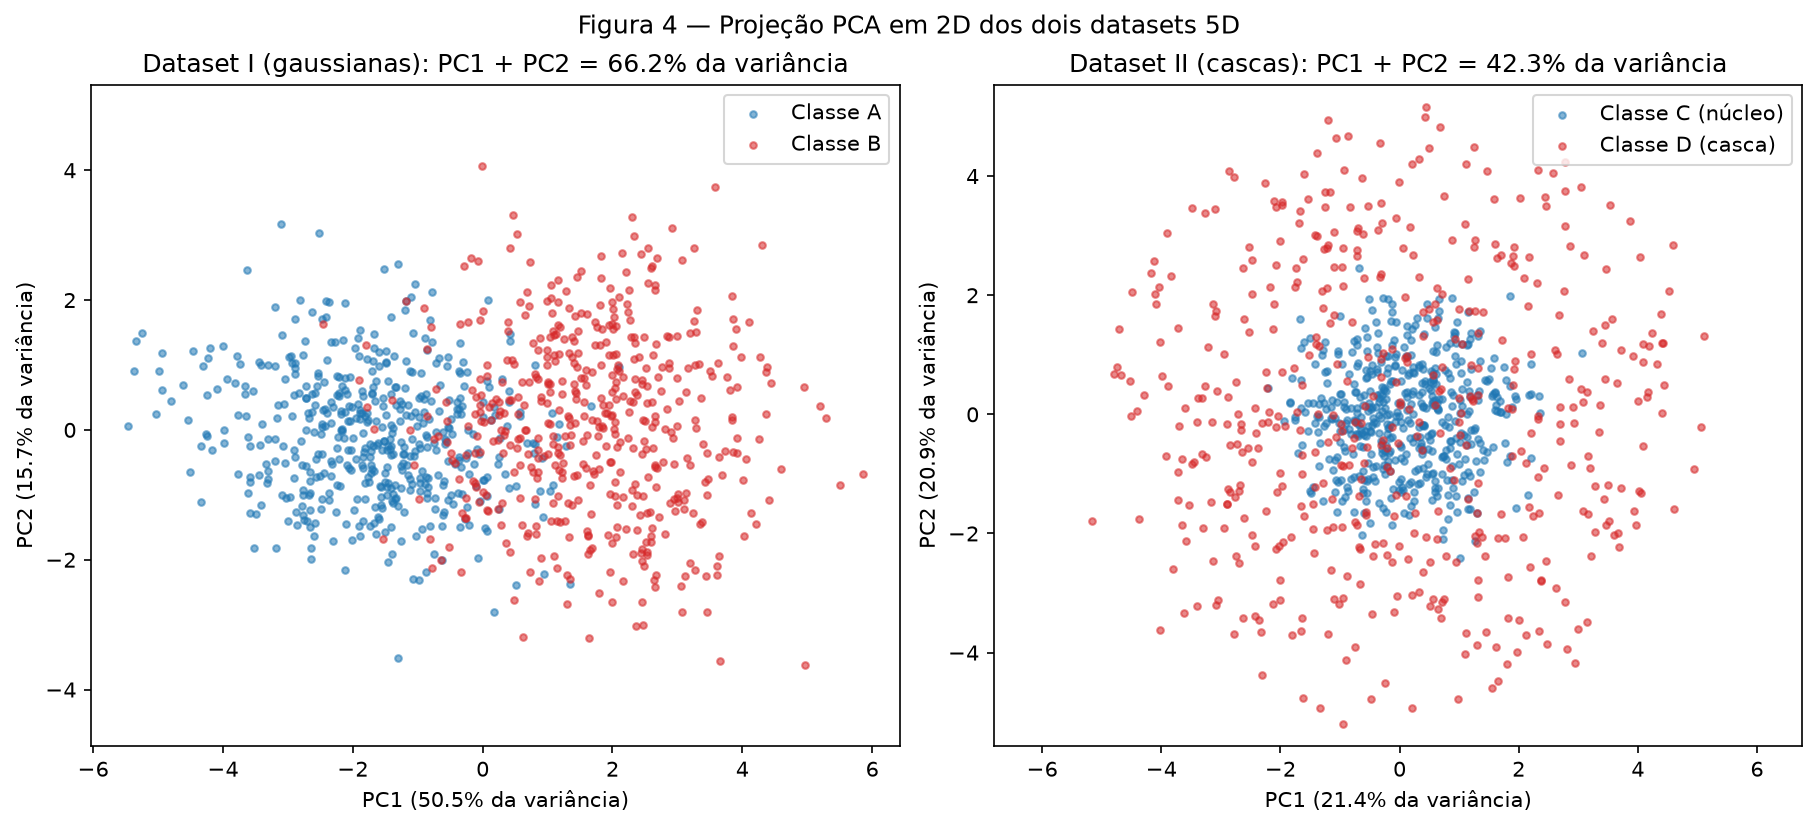
Figura 4 — Projeção PCA em 2D de cada dataset. Cada PCA é ajustado no próprio dataset.
| Medida | Dataset I (gaussianas) | Dataset II (cascas) |
|---|---|---|
| Variância explicada — PC1 | 50.5% | 21.4% |
| Variância explicada — PC2 | 15.7% | 20.9% |
| Variância explicada — PC1 + PC2 | 66.2% | 42.3% |
| Distância entre os centros das classes (5D) | 3.399 | 0.222 |
| Distância teórica entre os centros | \(\lVert \mu_B - \mu_A \rVert = 1.5\sqrt{5} = 3.354\) | 0 |
| Raio médio — 1ª classe (A / C) | 2.07 | 2.00 |
| Raio médio — 2ª classe (B / D) | 4.21 | 5.02 |
Qual projeção preserva melhor a informação para classificar? A do Dataset I. A diferença entre as classes é o deslocamento \(\mu_B - \mu_A = 1.5 \cdot (1,1,1,1,1)\), uma direção fixa. O PC1 captura essa direção (50.5% da variância), e as classes aparecem lado a lado ao longo dele. No Dataset II não existe direção preferida. Os 5 componentes explicam cerca de 20% cada, e o valor 42.3% está perto de \(2/5 = 40\%\). A projeção joga fora 57.7% da variância. Um ponto da casca cuja direção está nos componentes descartados cai perto do centro da projeção, em cima do núcleo.
Distância entre os centros (5D). No Dataset I, os centros ficam a 3.40 um do outro (teoria: 3.35). No Dataset II, a distância é 0.22, quase zero: as duas classes têm o mesmo centro, a origem. O pequeno desvio vem da amostra finita.
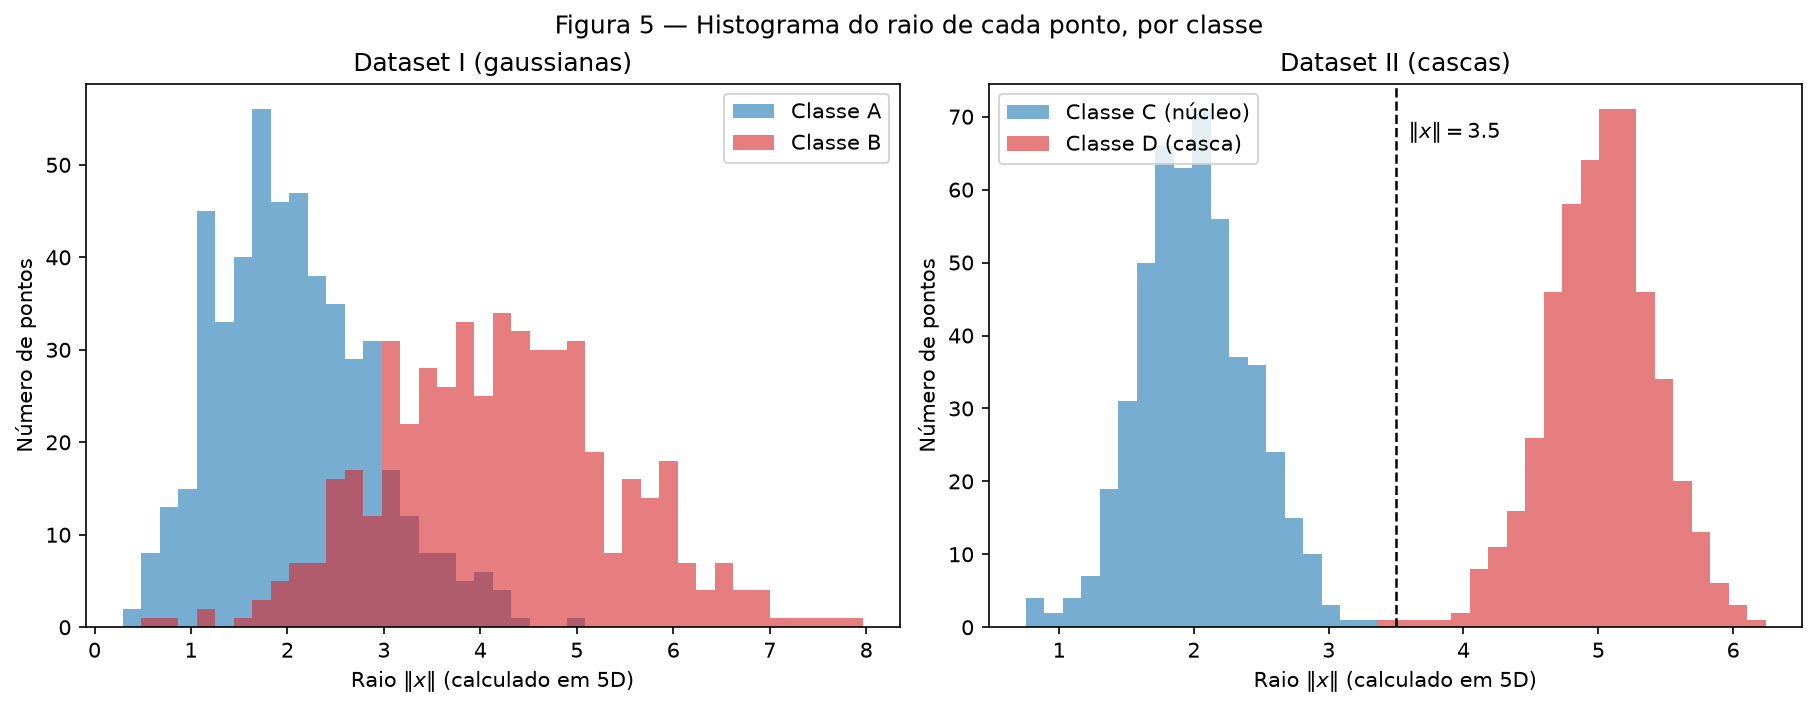
Figura 5 — Histograma do raio \(\lVert x \rVert\) (calculado em 5D), com as duas classes no mesmo eixo.
No Dataset I, os raios se sobrepõem muito: a classe A vai até 4.97 e a classe B começa em 0.67. No Dataset II, os raios não se sobrepõem: o núcleo vai de 0.75 a 3.28, e a casca vai de 3.44 a 6.24.
D — Analysis
Centros coincidentes e raios separados: o que isso diz sobre um hiperplano? As classes do Dataset II não diferem na posição do centro. Elas diferem na distância até a origem. Um hiperplano \(w^\top x + b = 0\) separa o espaço em dois lados. A regra de decisão dele depende de uma direção. A casca, porém, envolve o núcleo em todas as direções. Por isso nenhum hiperplano deixa o núcleo de um lado e a casca inteira do outro.
Por que nenhuma quantidade de dados resolve isso? Tome qualquer hiperplano, com \(\lVert w \rVert = 1\), e suponha que o núcleo fique no lado \(w^\top x + b < 0\):
- o núcleo tem pontos na direção \(+w\), com raio perto de 2: \(x = 2w\). Então \(2 + b < 0\), ou seja, \(b < -2\);
- a casca tem pontos na direção \(-w\), com raio perto de 5: \(x = -5w\). Para ficarem no outro lado, \(-5 + b > 0\), ou seja, \(b > 5\).
Não existe \(b\) que seja menor que \(-2\) e maior que \(5\) ao mesmo tempo. O problema está na geometria, e não na falta de amostras. Mais dados só preenchem melhor as direções \(+w\) e \(-w\) e tornam a contradição ainda mais certa.
Uma projeção 2D misturada prova que as classes são inseparáveis? Não. O PCA é linear: ele só gira os dados e descarta eixos. Se as classes se misturam nos 2 eixos que sobraram, a diferença pode estar nos eixos descartados ou numa função não linear dos eixos. Meus resultados mostram isso. Na Figura 4, o Dataset II parece misturado, com só 42.3% da variância. Mesmo assim, em 5D, o raio separa as classes sem sobreposição (Figura 5), e a distância entre centros é só 0.22, o que confirma que a informação não está na posição.
Uma função simples que separa o Dataset II:
O limiar \(3.5\) é o ponto médio dos raios do enunciado, \((2 + 5)/2\). Não o ajustei aos dados. Essa regra classifica corretamente 99.9% dos 1000 pontos. O único erro é o ponto da casca com o menor raio, 3.44, que fica abaixo de 3.5. Com a nova feature \(z = \lVert x \rVert^2\), a fronteira passa a ser linear: um único limiar em \(z\). Uma camada oculta faz esse tipo de transformação: ela cria features não lineares nas quais o problema fica linear.
Exercise 3
Abordagem. Primeiro, descrevo o train.csv inteiro. Depois, separo treino e teste antes de calcular qualquer estatística de transformação. A classe TanhPreprocessor concentra o pré-processamento: o método fit aprende tudo só no treino (medianas, modas, categorias, média e desvio), e o método transform aplica exatamente os mesmos valores ao treino e ao teste. No fim, verifico se sobrou NaN, qual é o formato final e qual é a faixa de valores.
Código — code/ex3_spaceship.py
| docs/exercises/data/code/ex3_spaceship.py | |
|---|---|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 173 174 175 176 177 178 179 | |
A — Get to know the data
Objetivo do dataset. No cenário da competição, a nave Spaceship Titanic bate numa anomalia do espaço-tempo, e parte dos passageiros vai parar em outra dimensão. A coluna Transported é o alvo: True quando o passageiro foi transportado para outra dimensão e False quando não foi. É um problema de classificação binária.
Balanço das classes. O arquivo tem 8693 passageiros e 14 colunas. True são 4378 (50.36%) e False são 4315 (49.64%). As classes estão praticamente equilibradas, então não é preciso reamostrar nem dar pesos diferentes às classes.
Features.
| Tipo | Colunas |
|---|---|
| Numéricas | Age, RoomService, FoodCourt, ShoppingMall, Spa, VRDeck |
| Categóricas | HomePlanet (3 planetas), CryoSleep (booleana), Destination (3 destinos), VIP (booleana), Cabin (texto deck/número/lado) |
| Identificadores | PassengerId (grupo_número), Name |
| Alvo | Transported (booleana) |
Valores ausentes por coluna (arquivo inteiro, 8693 linhas):
| Coluna | Ausentes | % |
|---|---|---|
PassengerId | 0 | 0.00% |
HomePlanet | 201 | 2.31% |
CryoSleep | 217 | 2.50% |
Cabin | 199 | 2.29% |
Destination | 182 | 2.09% |
Age | 179 | 2.06% |
VIP | 203 | 2.34% |
RoomService | 181 | 2.08% |
FoodCourt | 183 | 2.11% |
ShoppingMall | 208 | 2.39% |
Spa | 183 | 2.11% |
VRDeck | 188 | 2.16% |
Name | 200 | 2.30% |
Transported | 0 | 0.00% |
Todas as features têm entre 2% e 2.5% de ausentes. Só o identificador e o alvo estão completos.
Colunas de gasto (arquivo inteiro, sem os NaN):
| Coluna | Média | Mediana | Máximo |
|---|---|---|---|
RoomService | 224.69 | 0.00 | 14327 |
FoodCourt | 458.08 | 0.00 | 29813 |
ShoppingMall | 173.73 | 0.00 | 23492 |
Spa | 311.14 | 0.00 | 22408 |
VRDeck | 304.85 | 0.00 | 24133 |
Média × mediana. A mediana é 0 nas cinco colunas: mais da metade dos passageiros não gastou nada em cada serviço. A média, porém, fica entre 174 e 458, e o máximo chega a dezenas de milhares. Poucos passageiros gastam muito e puxam a média para cima. Então as distribuições têm assimetria forte à direita (cauda longa): quase todos os valores estão em 0, e o espalhamento vem de uma minoria com gastos extremos.
B — Split before you transform
Uso train_test_split(X, y, test_size=0.2, stratify=y, random_state=42). O treino fica com 6954 linhas e o teste com 1739. A estratificação mantém o balanço: True é 50.36% no treino e 50.37% no teste.
Por que o split vem antes da imputação e do escalonamento? O teste simula dados que o modelo nunca viu. Se a mediana da imputação ou a média e o desvio do escalonamento usarem linhas do teste, a informação do teste entra no treino (data leakage), e a nota no teste fica otimista. Por isso separo primeiro, calculo todas as estatísticas só no treino e transformo o teste com elas, como aconteceria com um dado novo.
C — Preprocess
A ordem dos passos é: imputação → TotalSpend → \(\log(1 + x)\) → padronização, com o one-hot em paralelo. Todos os objetos do scikit-learn recebem fit só com X_train.
Dados ausentes.
- Numéricas → mediana do treino (
SimpleImputer(strategy="median")). Os valores aprendidos sãoAge= 27 e 0 para os cinco gastos. Os gastos têm cauda longa: a média doFoodCourtno treino é 452.61, mas a mediana é 0. A média colocaria um gasto alto e raro em quem não tem registro. A mediana é robusta a esses extremos e, nos gastos, coincide com o comportamento mais comum, "não gastou". - Categóricas → moda do treino (
SimpleImputer(strategy="most_frequent")). Os valores aprendidos sãoHomePlanet= Earth,CryoSleep= False,Destination= TRAPPIST-1e eVIP= False. Só cerca de 2% dos valores faltam em cada coluna. A moda preenche esses poucos casos com uma categoria que já existe e não cria uma coluna extra, quase vazia, no one-hot.
Categóricas → one-hot. OneHotEncoder(handle_unknown="ignore") aprende as categorias do treino e cria 10 colunas: 3 de HomePlanet, 2 de CryoSleep, 3 de Destination e 2 de VIP.
Categoria nova no teste. Com handle_unknown="ignore", uma categoria que não existe no treino não gera erro: ela vira um vetor só de zeros nas colunas daquela feature. Testei isso no código: uma linha com HomePlanet = "Pluto" saiu com HomePlanet_Earth = HomePlanet_Europa = HomePlanet_Mars = 0. Para a rede, isso quer dizer "nenhum dos planetas conhecidos". Um NaN nunca chega ao encoder, porque a imputação vem antes.
Feature engineering. TotalSpend é a soma das cinco colunas de gasto, calculada depois da imputação para não somar NaN. Removo Cabin, Name e PassengerId.
Cauda longa → \(\log(1 + x)\). Aplico np.log1p às cinco colunas de gasto e ao TotalSpend. O \(+1\) mantém o zero em zero: \(\log(1 + 0) = 0\).
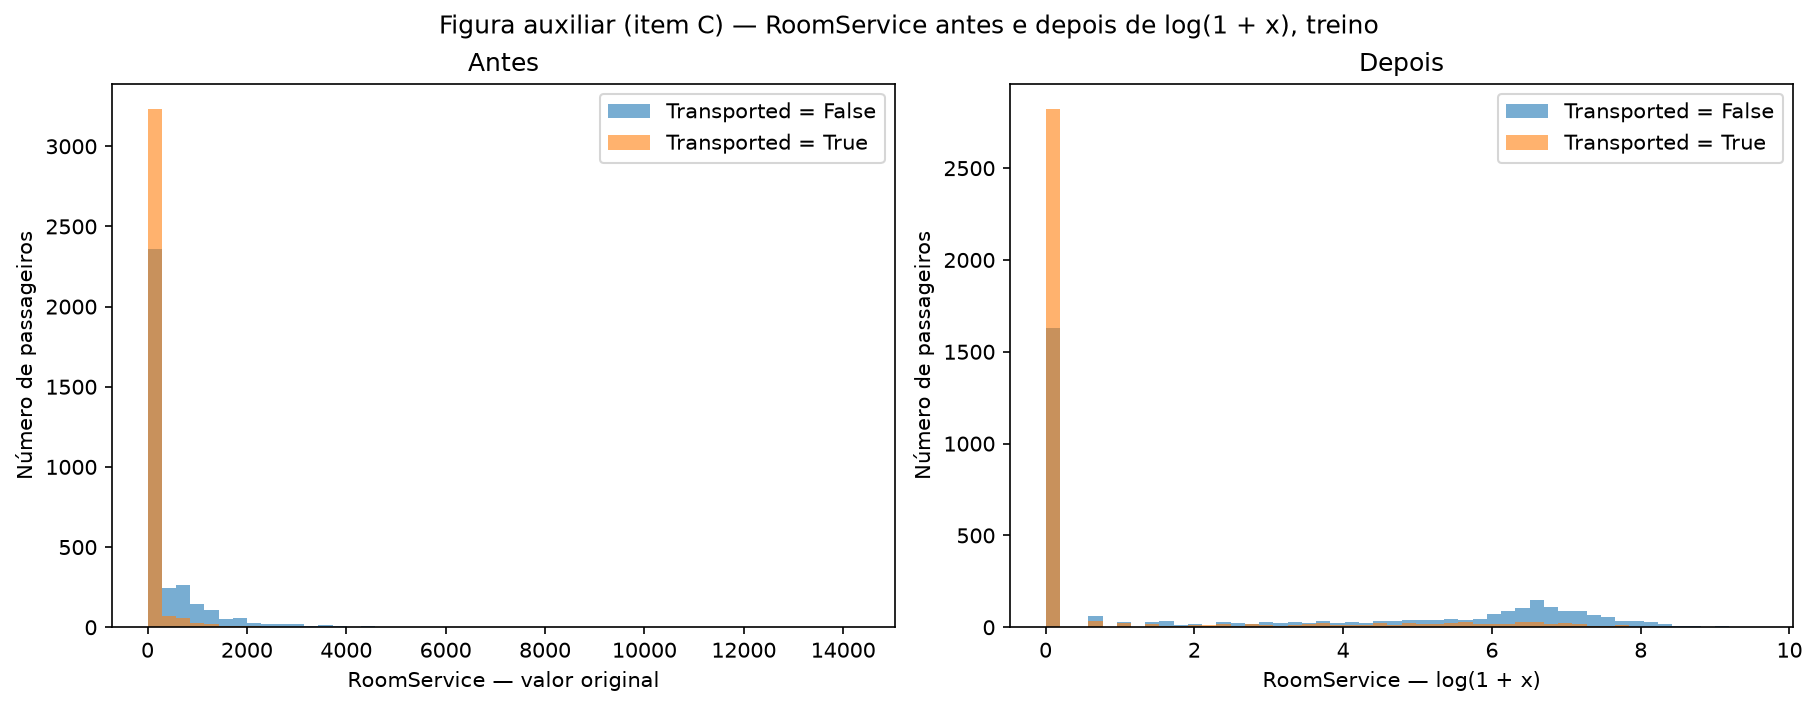
Figura auxiliar (item C) — RoomService no treino, antes e depois de \(\log(1 + x)\).
Por que isso ajuda uma rede com tanh? A tanh só é sensível perto de zero. A derivada é \(1 - \tanh^2(z)\): vale 1 em \(z = 0\), 0.07 em \(z = 2\) e 0.0099 em \(z = 3\). Sem o log, os gastos padronizados chegam a 18.26 a 22.27 desvios padrão acima da média no treino, e 1.93% dos valores ficam fora de \([-3, 3]\). Esses passageiros saturariam os neurônios (tanh ≈ 1, gradiente ≈ 0) e dominariam o ajuste dos pesos. O log comprime a cauda: um gasto de 14327 vira 9.57. Depois do log e da padronização, o máximo de cada gasto fica perto de 3, e só 0.06% dos valores numéricos passam de 3 em módulo.
Escalonamento → padronização (StandardScaler, média 0 e desvio 1), aplicada às 7 colunas numéricas: Age, os 5 gastos e TotalSpend. As colunas one-hot ficam em {0, 1}. Motivos da escolha:
- a tanh é centrada em zero, e entradas com média 0 mantêm as pré-ativações na região em que o gradiente é grande;
- todas as features ficam com a mesma escala (desvio 1), e nenhuma domina os pesos só pelo tamanho;
- depois do log não sobram extremos fortes, que eram a principal fraqueza da padronização.
A normalização para \([-1, 1]\) usaria o mínimo e o máximo do treino, que são justamente os valores mais extremos. Ela também não garante a faixa no teste.
Mínimo e máximo depois do escalonamento (matriz completa, com o one-hot):
| Conjunto | Mínimo | Máximo |
|---|---|---|
| Treino | −1.996 | 3.508 |
| Teste | −1.996 | 3.369 |
Os dois extremos vêm de Age: 0 anos (−1.996) e 79 anos (3.508). No treino, cada coluna padronizada tem média 0.000 e desvio 1.000.
D — Verify and visualize
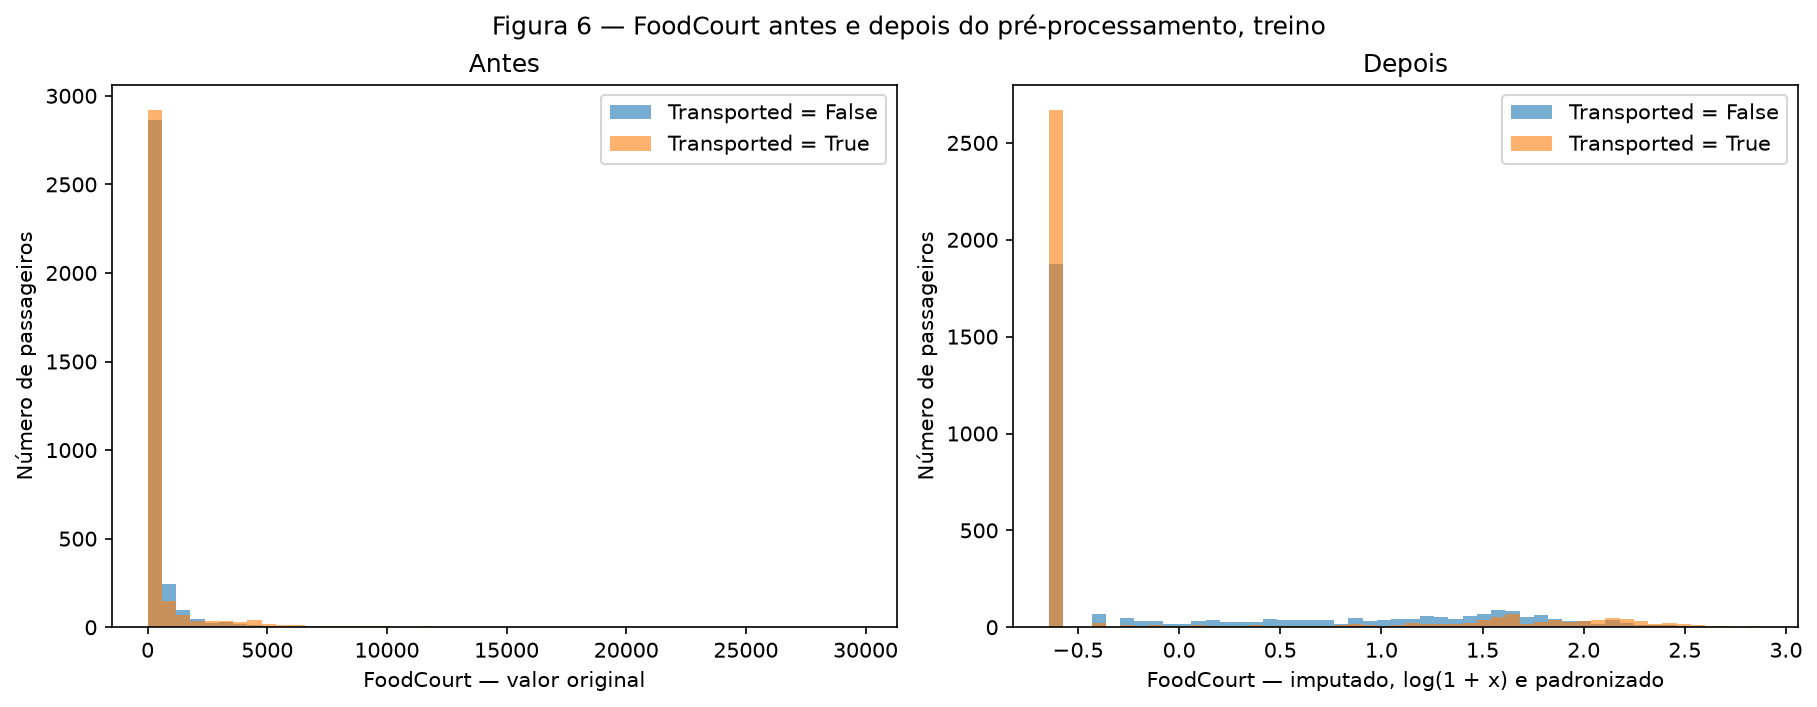
Figura 6 — FoodCourt no treino: valor original (esquerda) e depois de imputação, \(\log(1 + x)\) e padronização (direita).
Antes, quase todo o histograma é uma barra em 0, e a cauda vai até 29813. Depois, os valores de quem gastou ficam espalhados até 2.88. A barra dos que não gastaram continua lá, agora em −0.64, porque o log não muda a quantidade de zeros: ele só aproxima os valores altos.
Verificações finais:
| Verificação | Treino | Teste |
|---|---|---|
| NaN restantes | 0 | 0 |
| Formato da matriz de features | (6954, 17) | (1739, 17) |
| Faixa de valores | [−1.996, 3.508] | [−1.996, 3.369] |
| Valores numéricos com \(\lvert z \rvert > 3\) | 0.06% | — |
As 17 features são 7 numéricas padronizadas e 10 colunas one-hot. A faixa é compatível com a tanh: todos os valores estão entre −2 e 3.5, centrados em 0, e quase nenhum fica na região em que a tanh satura.
Qual decisão mais afeta o treinamento da rede? O \(\log(1 + x)\) nos gastos. Seis das sete features numéricas são gastos, e todos têm mediana 0 e máximo na casa das dezenas de milhares. Sem o log, a padronização deixaria alguns passageiros a cerca de 20 desvios padrão da média (máximo de 18.26 a 22.27). Esses valores saturam a tanh, zeram o gradiente dos neurônios que os recebem e fazem os pesos se ajustarem a poucos casos extremos. A imputação afeta pouco, porque só cerca de 2% dos valores faltam em cada coluna. A escolha entre padronização e normalização também pesa menos, desde que o log venha antes.
Results summary
| # | Item | Your value |
|---|---|---|
| 1 | Mixing rate at \(s = 0.5\) | 0.0% (0 / 400) |
| 2 | Mixing rate at \(s = 1.0\) | 5.0% (20 / 400) |
| 3 | Mixing rate at \(s = 2.0\) | 19.25% (77 / 400) |
| 4 | Mixing rate at \(s = 4.0\) | 48.25% (193 / 400) |
| 5 | Smallest \(r_{ij}\) at \(s = 1.0\), and which pair | \(r_{01} = 1.33\), par (0, 1) |
| 6 | Distance between centers — Dataset I | 3.399 |
| 7 | Distance between centers — Dataset II | 0.222 |
| 8 | Explained variance PC1 + PC2 — Dataset I | 66.2% |
| 9 | Explained variance PC1 + PC2 — Dataset II | 42.3% |
| 10 | Share of the positive class in Transported | 50.36% (4378 / 8693) |
| 11 | Mean and median of FoodCourt on the training set, before transforming | média 452.61; mediana 0.00 |
| 12 | Final shape of the training feature matrix | (6954, 17) |
| 13 | Minimum and maximum of the training and test sets after scaling | treino: −1.996 / 3.508; teste: −1.996 / 3.369 |